한빛미디어 서평단 <나는리뷰어다> 활동을 위해서 책을 협찬 받아 작성된 서평입니다.
토크나이저부터 Transformer, 사전 학습, SFT, DPO, GRPO까지 직접 구현해보는 LLM 입문서
요즘은 ChatGPT, Claude, Gemini와 같은 생성형 AI를 업무와 개발에 자연스럽게 활용하고 있다. 나 역시 여러 프로젝트에서 LLM을 자주 사용하고 있지만 실제로 입력한 문장이 어떤 과정을 거쳐 처리되고 다음 토큰이 생성되는지까지 깊게 들여다볼 기회는 많지 않았다. API를 호출하고 결과를 활용하는 데 익숙해질수록 모델 내부에서는 어떤 일이 일어나는지 궁금해지는 순간이 있다. Transformer가 어떻게 동작하는지, 토크나이저는 어떤 방식으로 텍스트를 나누는지, 사전 학습을 마친 모델이 어떤 과정을 거쳐 사람의 의도에 맞게 조정되는지 하나씩 확인해보고 싶었다. 한빛미디어의 '밑바닥부터 시작하는 딥러닝 6'은 이런 궁금증을 직접 코드로 따라가며 풀어볼 수 있는 책이다.
책의 개요
'밑바닥부터 시작하는 딥러닝 6'은 사이토 고키가 집필하고 개앞맵시 이복연이 번역한 '밑바닥부터 시작하는 딥러닝' 시리즈의 여섯 번째 책이다. 부제는 '토크나이저부터 추론 모델까지 직접 만드는 LLM'이다. 텍스트를 토큰으로 변환하는 과정에서 시작해 Transformer 기반 언어 모델을 구현하고, 사전 학습과 SFT, DPO, GRPO까지 이어진다. LLM이 만들어지고 학습되는 전체 흐름을 한 권에서 차례대로 따라갈 수 있도록 구성되어 있다.
최근 LLM 관련 자료를 살펴보면 RAG, AI Agent, 프롬프트 엔지니어링처럼 이미 만들어진 모델을 활용하는 주제를 자주 접하게 된다. 이 책에서는 모델 내부로 시선을 옮긴다. 토크나이저가 텍스트를 어떻게 처리하는지부터 모델 구조와 학습 과정, 사후 학습까지 직접 살펴본다. LLM을 사용하는 과정에서 한 단계 더 들어가 모델 자체를 이해하고 싶은 독자에게 잘 맞는 책이다.
저자 소개
저자인 사이토 고키는 '밑바닥부터 시작하는 딥러닝' 시리즈로 국내 개발자들에게도 익숙한 저자이다. 이 시리즈는 신경망의 기본 연산부터 직접 구현하면서 딥러닝의 원리를 이해하도록 구성되어 있다. 첫 번째 책에서 신경망을 다룬 이후 자연어 처리, 딥러닝 프레임워크, 강화 학습, 생성 모델로 주제를 확장해왔고 여섯 번째 책에서는 LLM을 중심으로 토크나이저, Transformer, 학습과 사후 학습을 다룬다. 시리즈 전체를 놓고 보면 딥러닝 기술이 발전해온 흐름을 함께 살펴보는 재미도 있다.
책의 구성과 주요 내용
책은 기본편, 응용편, 도전편으로 나뉜다. 기본편에서는 CodeBot을 만든다. 문자와 바이트 단위의 토큰화부터 시작해 BPE(Byte Pair Encoding)를 직접 구현하고 Attention, Transformer, 위치 인코딩, Attention Mask, Multi-Head Attention 등을 차례로 살펴본다. 이후 사전 학습과 텍스트 생성, SFT를 거쳐 강화 학습과 정책 경사법, GRPO까지 이어간다. 텍스트가 토큰으로 변환되고 모델이 학습된 뒤 다시 텍스트를 생성하는 과정이 하나의 흐름으로 연결된다.
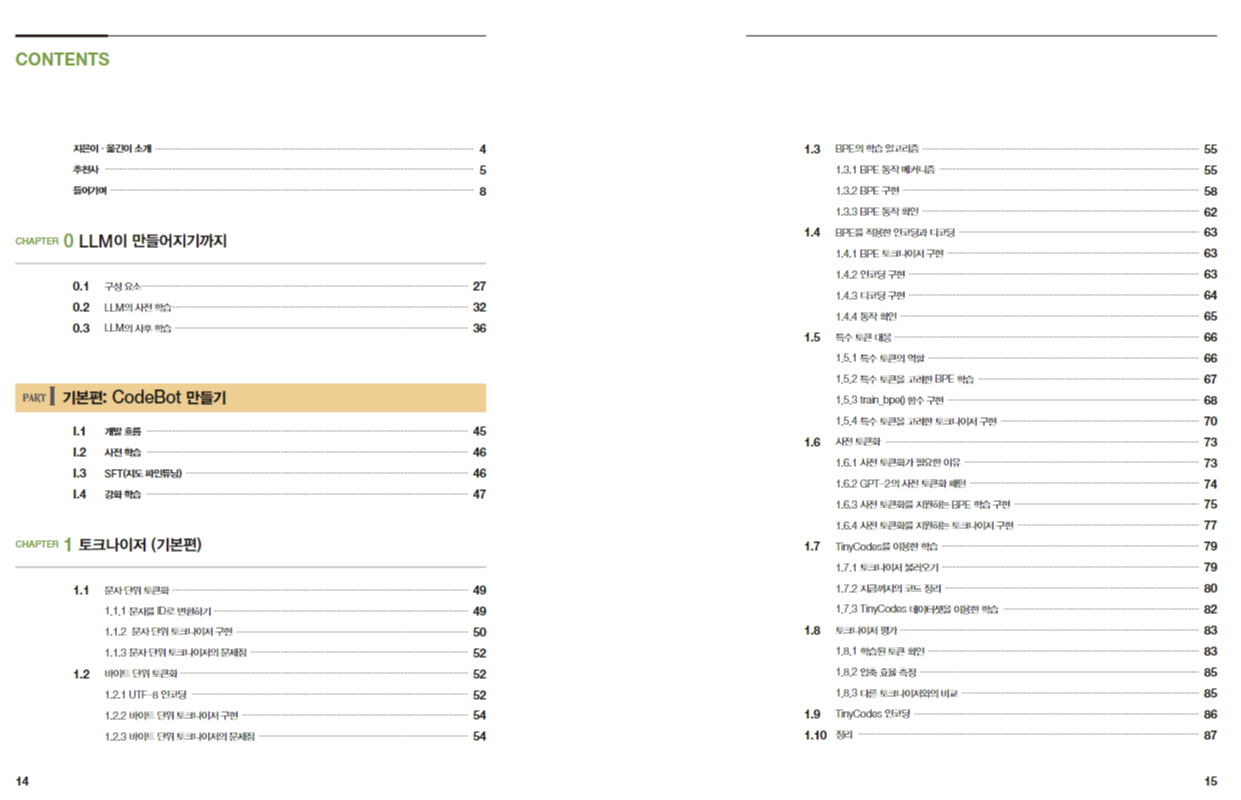
응용편에서는 StoryBot을 만들며 모델과 학습 방식을 개선한다. RoPE, SwiGLU, RMSNorm, KV Cache를 적용하고 AdamW, Learning Rate Schedule, Mixed Precision 등 학습 효율과 관련된 내용도 다룬다. RLHF와 DPO 역시 이 과정에서 등장한다. 최근 LLM 관련 글과 논문에서 자주 보게 되는 기술이 실제 모델 안에서 어떤 역할을 하는지 확인할 수 있다.
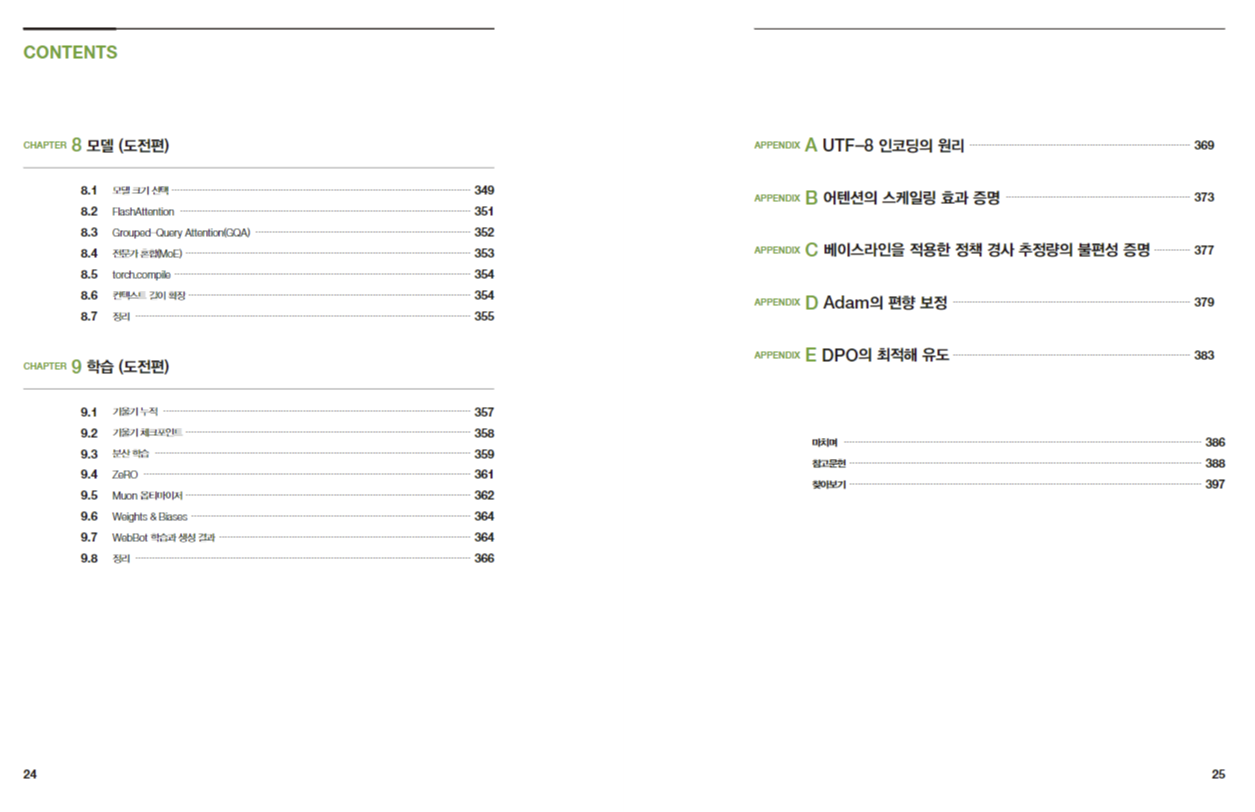
도전편에서는 WebBot을 만든다. 토크나이저의 병목을 찾고 Rust와 C++를 활용해 속도를 개선하며 FlashAttention, GQA(Grouped-Query Attention), MoE(Mixture of Experts), torch.compile, 컨텍스트 길이 확장을 살펴본다. 학습 부분에서는 Gradient Accumulation, Gradient Checkpointing, 분산 학습, ZeRO, Muon Optimizer, Weights & Biases까지 이어진다. 기본적인 언어 모델 구현에서 시작해 성능과 메모리, 확장성까지 고민하는 단계로 범위가 넓어진다.
직접 구현하면서 이해하는 LLM
'밑바닥부터 시작하는 딥러닝' 시리즈의 장점은 직접 구현하는 과정에서 기술의 구조를 확인할 수 있다는 점이다. Hugging Face Transformers와 같은 라이브러리를 활용하면 모델과 토크나이저를 빠르게 불러올 수 있고 실제 개발에서도 이런 방식이 효율적이다. 직접 구현하는 과정에서는 평소 라이브러리가 대신 처리해주던 부분을 하나씩 들여다보게 된다. 편리하게 사용하던 기능이 내부에서 어떤 원리로 동작하는지 코드와 함께 확인할 수 있다.
BPE에서는 어떤 기준으로 토큰이 병합되는지 살펴보고 Attention에서는 Query, Key, Value가 어떤 역할을 하는지 확인한다. Multi-Head Attention에서는 여러 Attention Head가 어떻게 처리되는지도 코드로 따라간다. 평소 기술 용어나 라이브러리 기능으로만 알고 있던 개념이 실제 코드와 연결되면서 훨씬 구체적으로 다가온다. 직접 구현해보는 과정 자체가 이 책의 가장 큰 학습 방법이라고 생각한다.
인상 깊었던 부분
이번 책에서 가장 마음에 들었던 부분은 LLM의 여러 구성 요소를 하나의 흐름으로 연결해준다는 점이다. 토크나이저, Transformer, 사전 학습, SFT, DPO, GRPO를 각각 공부할 때는 기술 사이의 관계가 한눈에 들어오지 않을 수 있다. 이 책에서는 하나의 모델을 만들고 개선하는 과정에 맞춰 기술이 차례로 등장한다. 각 기술이 왜 필요한지 앞뒤 맥락과 함께 이해할 수 있다는 점이 좋았다.
RoPE가 어느 부분에 적용되는지, KV Cache가 어떤 상황에서 필요한지, GQA가 무엇을 개선하는지, DPO와 GRPO가 학습 과정에서 어떤 역할을 맡는지도 자연스럽게 이어진다. FlashAttention, MoE, ZeRO처럼 이름만 알고 있던 기술도 전체 구조 안에서 위치를 잡아볼 수 있다. LLM 관련 글이나 논문을 읽을 때 각 기술이 전체 모델에서 어디에 해당하는지 파악하는 데 도움이 될 것 같다.
책의 특징
이 책의 첫 번째 특징은 LLM의 전체 흐름을 한 권에서 따라갈 수 있다는 점이다. 토크나이저부터 모델 구조, 사전 학습, SFT, 사후 학습까지 이어지며 각 과정에서 필요한 기술을 함께 살펴본다. 개별 기술을 따로 암기하기보다 하나의 언어 모델을 만드는 과정 속에서 이해할 수 있다.
두 번째 특징은 CodeBot, StoryBot, WebBot을 거치며 난이도가 점차 높아지는 구성이다. CodeBot에서는 기본 구조를 만들고 StoryBot에서는 모델과 학습 방식을 개선한다. WebBot에서는 속도, 메모리, 분산 학습, 확장성까지 살펴본다. 책을 따라가는 과정 자체가 하나의 모델을 계속 개선해나가는 과정처럼 구성되어 있다.
세 번째 특징은 현대 LLM에서 자주 언급되는 기술을 폭넓게 다룬다는 점이다. RoPE, SwiGLU, RMSNorm, KV Cache, FlashAttention, GQA, MoE, DPO, GRPO, ZeRO 등이 한 권에 등장한다. 각 기술의 세부 이론을 깊게 연구하기 위한 전문서보다는 LLM 전체 구조를 이해하면서 주요 기술을 직접 경험하는 데 적합하다. 최근 LLM 기술을 공부하기 위한 전체 지도를 그리는 데 도움이 되는 구성이다.
대상 독자
책의 난이도는 어느 정도 있는 편이다. 파이썬과 PyTorch를 사용해본 경험이 있고 딥러닝의 기본 개념을 알고 있다면 책의 흐름을 따라가기 수월하다. Transformer의 기본 구조나 신경망 학습 과정에 대한 이해가 있다면 코드와 설명을 연결하기도 편하다. 딥러닝의 기초를 익힌 뒤 LLM의 내부 구조까지 공부하려는 독자에게 가장 적합해 보인다.
Python이나 딥러닝을 처음 접하는 사람이라면 이전 시리즈나 별도의 딥러닝 입문서를 먼저 살펴보는 편이 좋을 것 같다. 뒤로 갈수록 코드와 개념이 복잡해지기 때문에 처음부터 모든 내용을 완벽하게 이해하려 하기보다 코드를 실행해보고 필요한 부분을 다시 확인하는 방식이 잘 맞을 것 같다.
추천 독자
LLM을 서비스에서 활용해본 개발자라면 특히 재미있게 읽을 수 있을 것 같다. ChatGPT나 Claude API를 이용해 기능을 만들면서 Transformer 내부 구조나 학습 과정이 궁금했던 사람이라면 배울 내용이 많다. AI 관련 논문이나 기술 문서를 자주 읽는 연구자에게도 도움이 된다. RoPE, GQA, MoE, DPO, GRPO처럼 자주 등장하는 개념을 코드와 함께 확인할 수 있기 때문이다. LLM을 활용하는 단계에서 내부 구조를 이해하는 단계로 공부 범위를 넓히고 싶은 사람에게 추천하고 싶다.
직접 작은 언어 모델을 만들어보고 싶은 사람에게도 잘 맞는다. 오픈소스 모델과 다양한 프레임워크 덕분에 LLM을 실행하는 일은 많이 쉬워졌지만 직접 모델 구조와 학습 과정을 구현해보는 경험은 또 다른 공부가 된다. 책의 예제를 따라가며 작은 모델부터 하나씩 만들어보는 방식으로 공부하기 좋다.
마치며
생성형 AI를 사용하는 방법은 갈수록 쉬워지고 있다. API를 호출하는 코드도 간단해졌고 공개된 모델을 로컬에서 실행하는 도구도 다양해졌다. 최근에는 원하는 기능을 자연어로 설명하면 AI가 필요한 코드까지 작성해준다. 이런 환경에서도 모델의 구조를 이해하는 지식은 여전히 중요하다. 새로운 논문에서 제안한 기술이 어떤 부분을 개선했는지, 모델의 속도나 메모리 문제가 어디에서 발생하는지, 서로 다른 모델 구조에는 어떤 차이가 있는지 판단하려면 기본 원리를 알고 있어야 한다. LLM을 활용하는 능력과 함께 내부 구조를 이해하는 능력도 중요해지고 있다고 생각한다.
'밑바닥부터 시작하는 딥러닝 6'은 토크나이저에서 시작해 Transformer를 만들고 모델을 학습한 뒤 SFT와 사후 학습을 거쳐 성능과 확장성을 개선하는 과정까지 다룬다. 책을 따라가다 보면 API 뒤에 있는 모델의 구조와 학습 과정이 이전보다 구체적으로 보이기 시작한다. LLM을 하나의 완성된 서비스가 아닌 직접 구현하고 분석할 수 있는 기술로 바라보게 해주는 책이다.
'밑바닥부터 시작하는 딥러닝' 시리즈를 이전부터 읽어왔다면 이번 6권의 주제도 반가울 것 같다. 신경망에서 시작한 시리즈가 자연어 처리와 강화 학습, 생성 모델을 거쳐 LLM까지 이어졌기 때문이다. LLM의 내부 구조와 학습 과정을 코드로 직접 확인해보고 싶은 사람이라면 한 번 읽어볼 만한 책이다.
'마음의 양식 > 독후감, 서평' 카테고리의 다른 글
| 누구나 작곡가가 되는 시대의 실습서, '유튜브에서 음원 발매까지 AI 플레이리스트' (0) | 2026.08.30 |
|---|---|
| AI 시스템 구축에 도움이 되는 '에이전트 시대의 AI 시스템 설계' (2) | 2026.08.08 |
| Claude를 가장 폭넓게 활용하는 방법, '클로드 올인원 with 코워크, 코드, 디자인' (0) | 2026.07.26 |
| AI가 더 잘 일하는 환경을 만드는 방법, '하네스 엔지니어링 with 클로드 코드' (0) | 2026.06.29 |
| 마카오에 가기 전에 '리얼 마카오'를 읽자 (0) | 2026.06.24 |
| AI 시스템의 다음 단계, '에이전트 시대의 AI 시스템 설계' (0) | 2026.05.24 |
| 홍콩 여행 가기 전에 참고한 '리얼 홍콩' (0) | 2026.04.28 |
| AI를 함께 일하는 동료로 만드는 방법, '누구나 프로처럼 실전 AI 클로드 코워크 with 스킬, 플러그인' (0) | 2026.04.26 |
| Spring 개발자를 위한 AI 입문서 '이것이 Spring AI다(개정판)' (0) | 2026.03.10 |
| AI 에이전트 엔지니어링 (0) | 2026.02.20 |


댓글